

- Tham gia
- 19/9/2024
- Bài viết
- 147
Trong công việc thực tế của một Nhà khoa học Dữ liệu, sai lầm phổ biến nhất của những người thiếu kinh nghiệm là vội vã viết code huấn luyện mô hình ngay khi vừa nhận được dữ liệu. Nếu thiếu đi một quy trình chuẩn hóa, dự án sẽ rất nhanh chóng rơi vào tình trạng bế tắc: mô hình đạt độ chính xác cao trên máy tính cá nhân nhưng hoàn toàn không thể giải quyết được bài toán kinh doanh thực tế.
Bài viết này sẽ hướng dẫn bạn quy trình 5 bước tiêu chuẩn công nghiệp dựa trên khung phương pháp luận CRISP-DM (Cross-Industry Standard Process for Data Mining) để tự tay thiết kế và triển khai một dự án Khoa học Dữ liệu hoàn chỉnh.
Định lượng tiêu chuẩn thành công bằng con số cụ thể: Mô hình dự báo cần đạt độ nhạy Recall > 85% đối với nhóm khách hàng VIP để đội ngũ chăm sóc khách hàng kịp thời can thiệp.
Xác định các ràng buộc thực thi: Thời gian phản hồi của API phải dưới 200 mili-giây.

Thực hiện phân tích khám phá (Exploratory Data Analysis): Kiểm tra tỷ lệ dữ liệu bị thiếu (Missing values), phát hiện các điểm ngoại lệ bất thường (Outliers) và đánh giá mức độ tương quan giữa các biến độc lập.

Trích xuất đặc trưng mới mang hàm ý nghiệp vụ: Tính toán biến động chi tiêu trong 3 tháng gần nhất, tỷ lệ phản hồi chiến dịch tiếp thị và khoảng thời gian kể từ lần tương tác cuối cùng.
Chuẩn hóa thang đo và mã hóa các biến danh mục bằng các kỹ thuật Target Encoding hoặc Weight of Evidence.

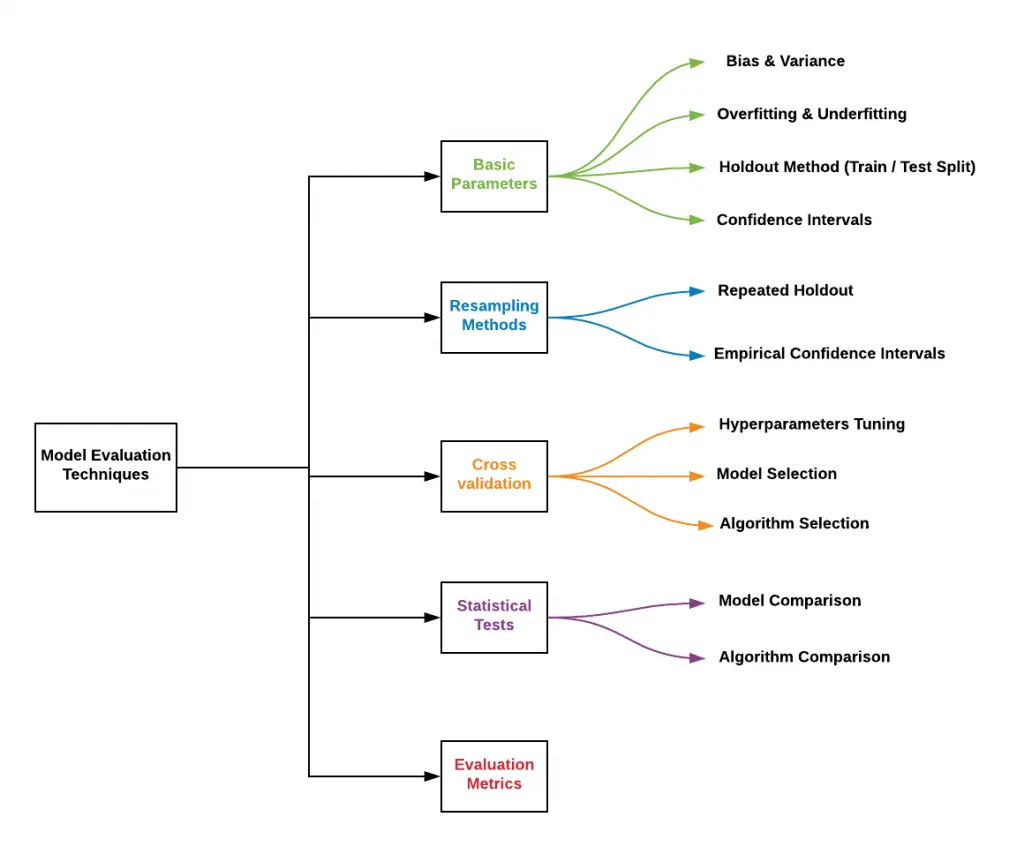
Thử nghiệm nhiều thuật toán khác nhau: Từ các mô hình baseline đơn giản (Logistic Regression) đến các mô hình ensemble phức tạp (Random Forest, XGBoost, LightGBM).
Tối ưu hóa siêu tham số (Hyperparameter Tuning) bằng thuật toán tìm kiếm Bayesian Optimization để tìm ra điểm cân bằng tối ưu giữa Bias và Variance.
Đối soát kết quả dự báo với chỉ số ROI kinh doanh để đảm bảo mô hình thực sự mang lại lợi nhuận cho doanh nghiệp.
Xây dựng dịch vụ API dự báo bằng FastAPI và đóng gói toàn bộ ứng dụng vào Docker Container.
Triển khai lên hệ thống máy chủ Cloud, kết nối trực tiếp với ứng dụng nghiệp vụ của doanh nghiệp và thiết lập bảng dashboard giám sát độ ổn định của mô hình.
Cạm bẫy tối ưu quá mức thuật toán (Premature Optimization): Dành quá nhiều thời gian tinh chỉnh các siêu tham số của mô hình Deep Learning phức tạp trong khi chất lượng dữ liệu đầu vào còn quá nhiều nhiễu và sai lệch.
Cạm bẫy thiếu sự tham gia của chuyên gia nghiệp vụ: Không tham khảo ý kiến của những người trực tiếp vận hành kinh doanh, dẫn đến việc thiết kế các đặc trưng không có giá trị thực tiễn.
Làm chủ quy trình 5 bước triển khai dự án Khoa học Dữ liệu chính là bảo chứng vững chắc nhất cho năng lực kỹ thuật của một Fullstack Data Scientist chuyên nghiệp, mở ra vô số cơ hội thăng tiến vượt bậc trong sự nghiệp.
Bài viết này sẽ hướng dẫn bạn quy trình 5 bước tiêu chuẩn công nghiệp dựa trên khung phương pháp luận CRISP-DM (Cross-Industry Standard Process for Data Mining) để tự tay thiết kế và triển khai một dự án Khoa học Dữ liệu hoàn chỉnh.
1. Quy Trình 5 Bước Triển Khai Dự Án Khoa Học Dữ Liệu
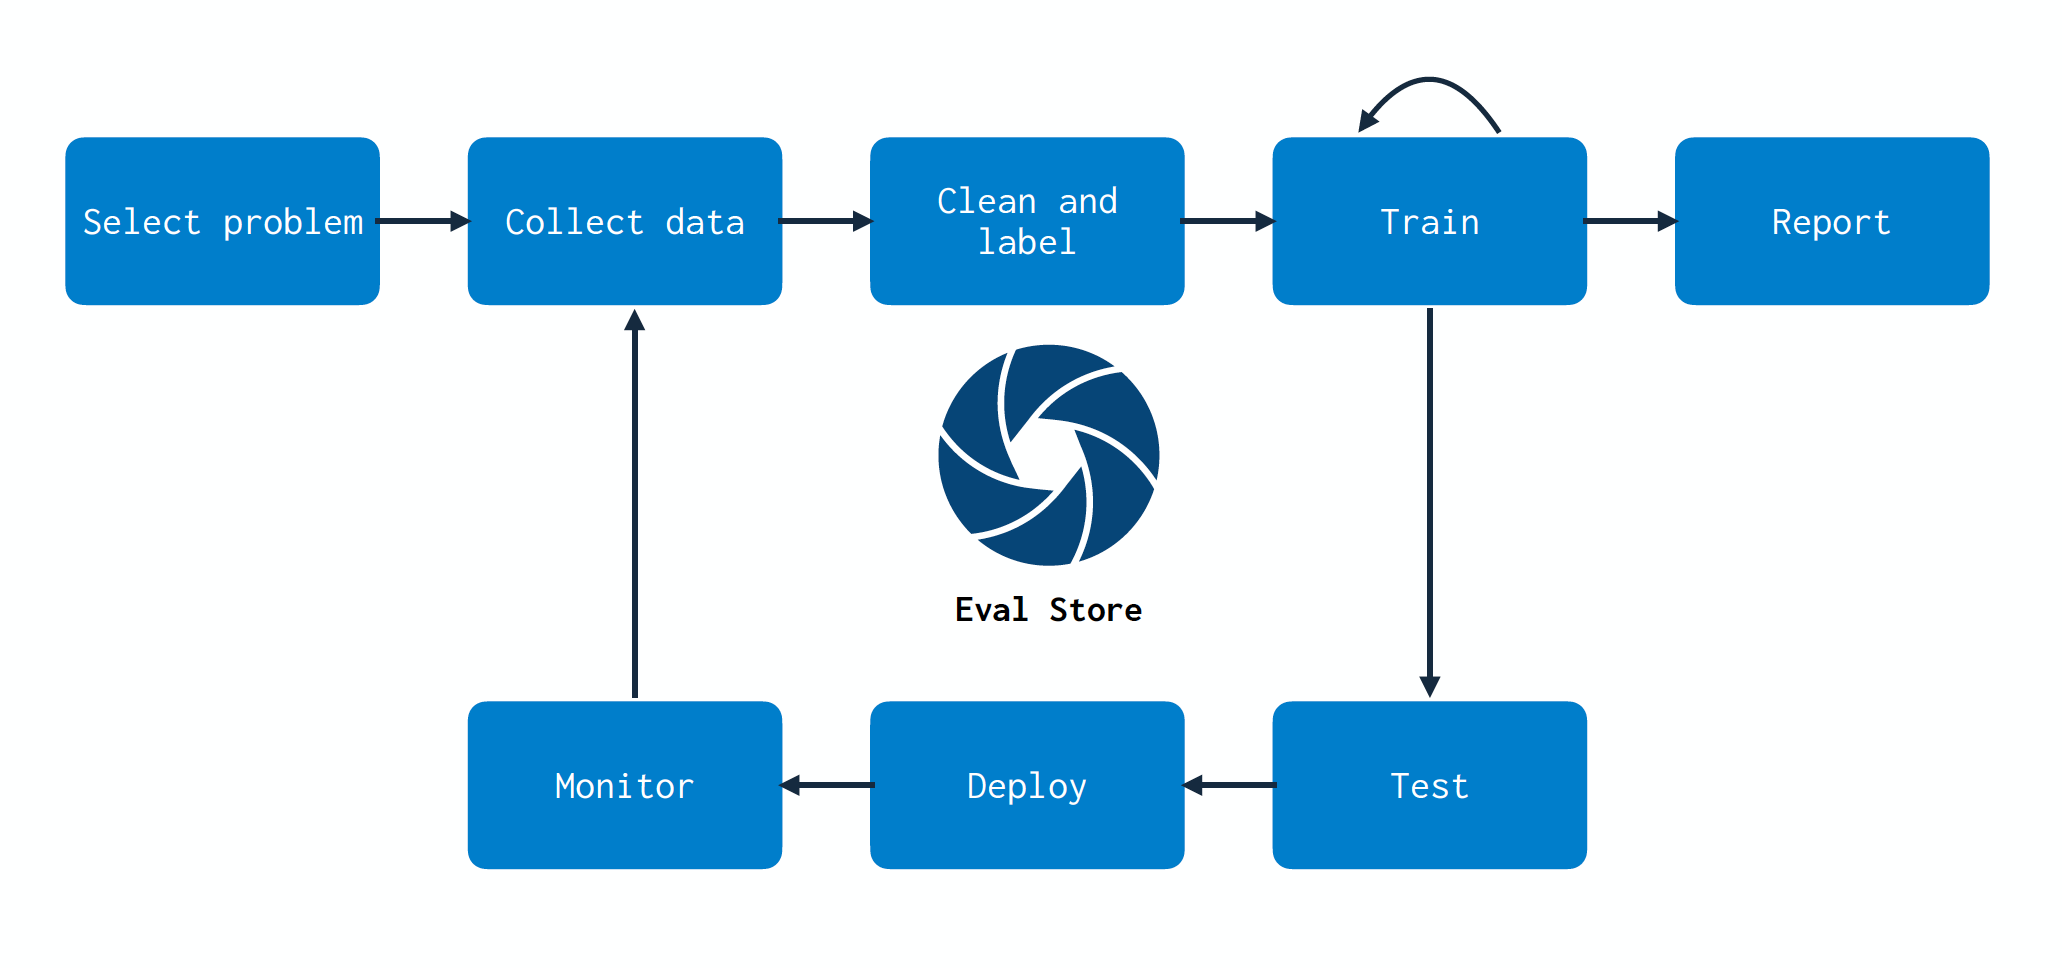
Bước 1: Thấu hiểu bài toán kinh doanh và định nghĩa mục tiêu (Business Understanding):
Làm việc trực tiếp với các bên liên quan để xác định bài toán gốc: Doanh nghiệp đang gặp nỗi đau gì? (Ví dụ: Tỷ lệ khách hàng hủy dịch vụ viễn thông tăng vọt 15% trong quý trước).Định lượng tiêu chuẩn thành công bằng con số cụ thể: Mô hình dự báo cần đạt độ nhạy Recall > 85% đối với nhóm khách hàng VIP để đội ngũ chăm sóc khách hàng kịp thời can thiệp.
Xác định các ràng buộc thực thi: Thời gian phản hồi của API phải dưới 200 mili-giây.
Bước 2: Thu thập dữ liệu và phân tích khám phá (Data Understanding & EDA):
Kết nối vào các kho dữ liệu (SQL Databases, Data Lakehouse) để trích xuất các bảng dữ liệu liên quan: Thông tin định danh khách hàng, lịch sử giao dịch, tần suất sử dụng dịch vụ và lịch sử khiếu nại.Thực hiện phân tích khám phá (Exploratory Data Analysis): Kiểm tra tỷ lệ dữ liệu bị thiếu (Missing values), phát hiện các điểm ngoại lệ bất thường (Outliers) và đánh giá mức độ tương quan giữa các biến độc lập.
Bước 3: Chuẩn bị dữ liệu và biến đổi đặc trưng (Data Preparation & Feature Engineering):
Làm sạch dữ liệu: Xử lý giá trị rỗng bằng các phương pháp nội suy phù hợp, xử lý các điểm dữ liệu dị biệt bằng kỹ thuật cắt tỉa bách phân vị.Trích xuất đặc trưng mới mang hàm ý nghiệp vụ: Tính toán biến động chi tiêu trong 3 tháng gần nhất, tỷ lệ phản hồi chiến dịch tiếp thị và khoảng thời gian kể từ lần tương tác cuối cùng.
Chuẩn hóa thang đo và mã hóa các biến danh mục bằng các kỹ thuật Target Encoding hoặc Weight of Evidence.
Bước 4: Huấn luyện và đánh giá mô hình dự đoán (Modeling & Evaluation):
Chia tách dữ liệu nghiêm ngặt thành tập Huấn luyện (Train set), tập Hiệu chỉnh (Validation set) và tập Kiểm thử độc lập (Test set).Thử nghiệm nhiều thuật toán khác nhau: Từ các mô hình baseline đơn giản (Logistic Regression) đến các mô hình ensemble phức tạp (Random Forest, XGBoost, LightGBM).
Tối ưu hóa siêu tham số (Hyperparameter Tuning) bằng thuật toán tìm kiếm Bayesian Optimization để tìm ra điểm cân bằng tối ưu giữa Bias và Variance.
Đối soát kết quả dự báo với chỉ số ROI kinh doanh để đảm bảo mô hình thực sự mang lại lợi nhuận cho doanh nghiệp.
Bước 5: Triển khai mô hình và thiết lập hệ thống giám sát (Deployment & Monitoring):
Đóng gói quy trình tiền xử lý và trọng số mô hình thành một đường ống thống nhất bằng Scikit-Learn Pipeline.Xây dựng dịch vụ API dự báo bằng FastAPI và đóng gói toàn bộ ứng dụng vào Docker Container.
Triển khai lên hệ thống máy chủ Cloud, kết nối trực tiếp với ứng dụng nghiệp vụ của doanh nghiệp và thiết lập bảng dashboard giám sát độ ổn định của mô hình.
2. Các Cạm Bẫy Cần Tránh Để Mô Hình Vận Hành Hiệu Quả
Cạm bẫy rò rỉ dữ liệu (Data Leakage): Sử dụng các thuộc tính chỉ xuất hiện sau khi sự kiện mục tiêu đã xảy ra để dự đoán sự kiện đó, khiến mô hình đạt độ chính xác giả tạo 99% trong phòng thí nghiệm nhưng thất bại hoàn toàn ngoài đời thực.Cạm bẫy tối ưu quá mức thuật toán (Premature Optimization): Dành quá nhiều thời gian tinh chỉnh các siêu tham số của mô hình Deep Learning phức tạp trong khi chất lượng dữ liệu đầu vào còn quá nhiều nhiễu và sai lệch.
Cạm bẫy thiếu sự tham gia của chuyên gia nghiệp vụ: Không tham khảo ý kiến của những người trực tiếp vận hành kinh doanh, dẫn đến việc thiết kế các đặc trưng không có giá trị thực tiễn.
3. Nâng Tầm Năng Lực Cùng Chuyên Gia Dữ Liệu
Để tự tay trải nghiệm trọn vẹn quy trình 5 bước chuyên sâu này trên các tập dữ liệu thực tế quy mô hàng triệu bản ghi, việc tiếp cận một chương trình đào tạo chuẩn mực là con đường ngắn nhất. Bạn có thể tham khảo Lộ trình học Data Science để được làm việc trực tiếp trên hạ tầng dữ liệu thật, nhận sự dẫn dắt 1-1 từ các Chuyên gia Dữ liệu hàng đầu để tự tay hoàn thiện các dự án Capstone chuẩn doanh nghiệp.Làm chủ quy trình 5 bước triển khai dự án Khoa học Dữ liệu chính là bảo chứng vững chắc nhất cho năng lực kỹ thuật của một Fullstack Data Scientist chuyên nghiệp, mở ra vô số cơ hội thăng tiến vượt bậc trong sự nghiệp.
