

MMZ2024
Thành viên
- Tham gia
- 21/10/2024
- Bài viết
- 23
NVIDIA tiếp tục mở rộng hệ sinh thái phần cứng AI với NVHBM, giải pháp bộ nhớ băng thông cao được thiết kế cho các hệ thống AI thế hệ mới. Công nghệ này hướng đến tốc độ truyền dữ liệu cao hơn, mức tiêu thụ điện thấp hơn và khả năng tận dụng silicon hiệu quả hơn cho các custom XPU.
Trong các hệ thống AI hiện đại, accelerator phải liên tục truy xuất lượng dữ liệu lớn từ bộ nhớ để xử lý model weights, activation, KV cache và nhiều dữ liệu trung gian. Vì vậy, hiệu năng của hệ thống không chỉ phụ thuộc vào năng lực tính toán mà còn nằm ở khả năng cung cấp dữ liệu cho compute. NVHBM được NVIDIA phát triển để giải quyết đồng thời ba vấn đề: băng thông, điện năng và diện tích silicon.
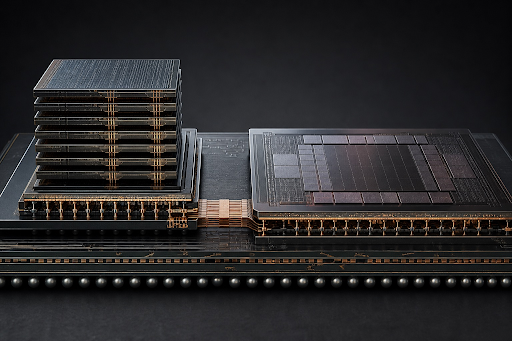
Băng thông lớn hơn giúp accelerator nhận dữ liệu nhanh hơn, đặc biệt hữu ích với những workload có cường độ truy cập bộ nhớ cao như AI training và inference. Đây cũng là yếu tố ngày càng quan trọng khi các mô hình AI có kích thước lớn và phải xử lý nhiều dữ liệu hơn.
Mức 30% ở đây là mức cải thiện về memory bandwidth, không đồng nghĩa hiệu năng của mọi ứng dụng AI đều tăng tương ứng.
Với một accelerator đơn lẻ, mức tiết kiệm này có thể không quá lớn. Nhưng khi triển khai hàng trăm hoặc hàng nghìn accelerator trong data center, hiệu quả năng lượng trên từng thành phần có thể tạo ra khác biệt đáng kể đối với nguồn điện và hệ thống tản nhiệt.
Không gian silicon được giải phóng có thể được sử dụng cho compute hoặc những thành phần khác trên XPU. NVIDIA cho biết thiết kế này có thể tạo thêm tới 25% diện tích die dành cho compute.
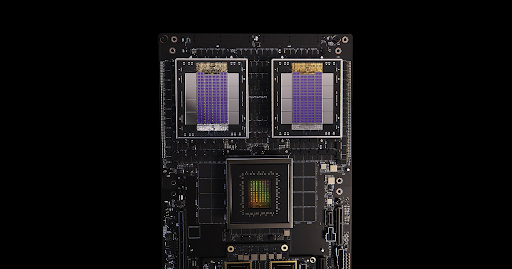
NVHBM hướng đến đúng điểm nghẽn đó bằng cách kết hợp băng thông cao hơn, điện năng thấp hơn và diện tích giao tiếp nhỏ hơn.
Đặc biệt với các data center AI quy mô lớn, việc tối ưu từng thành phần có thể giúp tăng hiệu quả sử dụng tài nguyên trên toàn hệ thống.
Giải pháp này được NVIDIA định hướng cho custom XPU và AI infrastructure, nơi yêu cầu về băng thông bộ nhớ và khả năng mở rộng cao hơn nhiều so với máy tính cá nhân. Với người dùng phổ thông, NVHBM đáng chú ý hơn ở góc độ công nghệ nền tảng phía sau sự phát triển của AI accelerator và data center.
Tóm lại, NVIDIA NVHBM cho thấy cuộc đua phần cứng AI đang chuyển từ việc đơn thuần tăng sức mạnh tính toán sang tối ưu toàn bộ đường đi của dữ liệu. Với mức cải thiện được NVIDIA công bố lên tới 30% memory bandwidth, giảm 15% HBM power và giảm 67% diện tích PHY, NVHBM là một bước tiếp cận đáng chú ý đối với thế hệ custom XPU và AI infrastructure. Khi AI tiếp tục mở rộng về quy mô, những công nghệ kết hợp giữa compute, memory và interconnect sẽ ngày càng giữ vai trò quan trọng trong việc nâng cao hiệu quả của toàn bộ hệ thống.
NVIDIA đưa NVHBM vào bài toán bộ nhớ AI như thế nào?
NVHBM (NVIDIA HBM) là giải pháp bộ nhớ HBM tùy chỉnh được NVIDIA phát triển cùng các đối tác sản xuất bộ nhớ, hướng đến custom XPU và hạ tầng AI quy mô lớn.Trong các hệ thống AI hiện đại, accelerator phải liên tục truy xuất lượng dữ liệu lớn từ bộ nhớ để xử lý model weights, activation, KV cache và nhiều dữ liệu trung gian. Vì vậy, hiệu năng của hệ thống không chỉ phụ thuộc vào năng lực tính toán mà còn nằm ở khả năng cung cấp dữ liệu cho compute. NVHBM được NVIDIA phát triển để giải quyết đồng thời ba vấn đề: băng thông, điện năng và diện tích silicon.
Ba con số cho thấy NVHBM được tối ưu ra sao
30% mức tăng memory bandwidth
Theo NVIDIA, NVHBM có memory bandwidth cao hơn tới 30% so với HBM4e tiêu chuẩn.Băng thông lớn hơn giúp accelerator nhận dữ liệu nhanh hơn, đặc biệt hữu ích với những workload có cường độ truy cập bộ nhớ cao như AI training và inference. Đây cũng là yếu tố ngày càng quan trọng khi các mô hình AI có kích thước lớn và phải xử lý nhiều dữ liệu hơn.
Mức 30% ở đây là mức cải thiện về memory bandwidth, không đồng nghĩa hiệu năng của mọi ứng dụng AI đều tăng tương ứng.
15% mức giảm HBM power
NVIDIA cho biết NVHBM có thể giảm tới 15% điện năng dành cho HBM so với HBM4e tiêu chuẩn.Với một accelerator đơn lẻ, mức tiết kiệm này có thể không quá lớn. Nhưng khi triển khai hàng trăm hoặc hàng nghìn accelerator trong data center, hiệu quả năng lượng trên từng thành phần có thể tạo ra khác biệt đáng kể đối với nguồn điện và hệ thống tản nhiệt.
67% diện tích PHY được cắt giảm
NVHBM còn được tối ưu ở phần giao tiếp giữa bộ nhớ và XPU. NVIDIA cho biết thiết kế này có thể giảm tới 67% diện tích PHY và support area so với HBM4e theo chuẩn JEDEC.Không gian silicon được giải phóng có thể được sử dụng cho compute hoặc những thành phần khác trên XPU. NVIDIA cho biết thiết kế này có thể tạo thêm tới 25% diện tích die dành cho compute.
Vì sao NVIDIA không chỉ tăng tốc độ HBM?
Điểm đáng chú ý của NVHBM nằm ở cách NVIDIA tiếp cận bộ nhớ như một phần của kiến trúc XPU, thay vì chỉ xem đây là một linh kiện độc lập. HBM4e cung cấp nền tảng bộ nhớ băng thông cao theo tiêu chuẩn. Trong khi đó, NVHBM sử dụng thiết kế tùy chỉnh để NVIDIA có thể tối ưu sâu hơn cho mục tiêu của custom XPU.Tiêu chí | HBM4e | NVIDIA NVHBM |
|---|---|---|
Thiết kế | Theo tiêu chuẩn HBM | Tùy chỉnh |
Memory bandwidth | Cao | Cao hơn tới 30% |
HBM power | Chuẩn tham chiếu | Giảm tới 15% |
PHY & support area | Thiết kế tiêu chuẩn | Giảm tới 67% |
Định hướng | AI/HPC | Custom XPU, AI infrastructure |
Như vậy, khác biệt của NVHBM không chỉ nằm ở tốc độ mà còn ở cách phân bổ tài nguyên silicon và mức tiêu thụ năng lượng.NVHBM đứng ở đâu trong hệ sinh thái AI của NVIDIA?
Bộ nhớ chỉ là một phần trong kiến trúc AI. NVIDIA đồng thời phát triển NVLink Fusion để giải quyết bài toán kết nối các custom XPU với hệ thống NVLink. Nếu NVHBM tập trung vào đường truyền dữ liệu giữa memory và compute, NVLink Fusion tập trung vào kết nối và mở rộng XPU trong hạ tầng AI. Hai công nghệ vì vậy bổ trợ cho nhau, phản ánh hướng đi của NVIDIA trong việc xây dựng một hệ sinh thái AI không chỉ dựa vào GPU mà còn bao gồm memory, interconnect và custom silicon.
NVHBM sẽ tác động thế nào đến hạ tầng AI?
Khi mô hình AI ngày càng lớn, các hệ thống phải xử lý nhiều dữ liệu hơn trong thời gian ngắn hơn. Điều này khiến memory bandwidth và hiệu quả năng lượng trở thành những yếu tố quan trọng bên cạnh sức mạnh compute.NVHBM hướng đến đúng điểm nghẽn đó bằng cách kết hợp băng thông cao hơn, điện năng thấp hơn và diện tích giao tiếp nhỏ hơn.
Đặc biệt với các data center AI quy mô lớn, việc tối ưu từng thành phần có thể giúp tăng hiệu quả sử dụng tài nguyên trên toàn hệ thống.
Người dùng PC có cần quan tâm đến NVHBM?
NVHBM hiện không phải công nghệ dành cho RAM hay VRAM trên PC gaming.Giải pháp này được NVIDIA định hướng cho custom XPU và AI infrastructure, nơi yêu cầu về băng thông bộ nhớ và khả năng mở rộng cao hơn nhiều so với máy tính cá nhân. Với người dùng phổ thông, NVHBM đáng chú ý hơn ở góc độ công nghệ nền tảng phía sau sự phát triển của AI accelerator và data center.
Tóm lại, NVIDIA NVHBM cho thấy cuộc đua phần cứng AI đang chuyển từ việc đơn thuần tăng sức mạnh tính toán sang tối ưu toàn bộ đường đi của dữ liệu. Với mức cải thiện được NVIDIA công bố lên tới 30% memory bandwidth, giảm 15% HBM power và giảm 67% diện tích PHY, NVHBM là một bước tiếp cận đáng chú ý đối với thế hệ custom XPU và AI infrastructure. Khi AI tiếp tục mở rộng về quy mô, những công nghệ kết hợp giữa compute, memory và interconnect sẽ ngày càng giữ vai trò quan trọng trong việc nâng cao hiệu quả của toàn bộ hệ thống.


